Schluss mit der Dateiablage: paperless‑ngx und lokale KI mit Ollama
Zusammenfassung
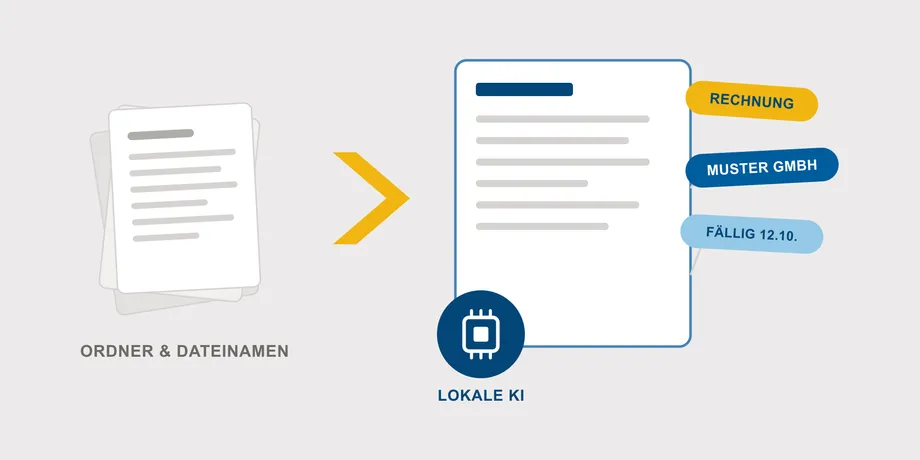
Viele kleine und mittelständische Unternehmen stecken bei der Digitalisierung noch in Stufe eins. Papier wird eingescannt, das PDF landet in einem Ordner auf dem File-Share, benannt nach mehr oder weniger konsequenter Konvention. Gefunden wird ein Dokument trotzdem meist nur, wenn man sich noch erinnert, wo es liegen müsste. paperless‑ngx geht diesen Schritt weiter: Dokumente bekommen Tags, Korrespondenten, Dokumenttypen und eine echte Volltextsuche und lassen sich über Workflows automatisch weiterverarbeiten, etwa eine Rechnung, die beim Import direkt als solche erkannt und per E-Mail an die Buchhaltung weitergereicht wird.
Mit Version 3.0 (Juli 2026) hat paperless‑ngx dieses Prinzip um native KI-Funktionen erweitert, und der direkte Nachfolger 3.1 hat kurz darauf nachgelegt: Ein Sprachmodell schlägt Tags, Dokumenttyp, Korrespondent und Titel vor, beantwortet Fragen zu einem einzelnen Dokument im Chat und findet über eine integrierte Ähnlichkeitssuche passenden Kontext aus anderen Dokumenten. Seit 3.1 lassen sich diese Vorschläge sogar automatisch als Workflow-Aktion übernehmen, ganz ohne Klick auf einen Button. Das Sprachmodell muss dabei nicht in der Cloud laufen. Über Ollama lässt sich derselbe Funktionsumfang komplett lokal betreiben. Rechnungen, Verträge und Personalunterlagen verlassen dabei zu keinem Zeitpunkt das eigene Netzwerk.
Dieser Beitrag ist ein fachlicher Überblick: Wie paperless‑ngx im Alltag eines kleinen Unternehmens oder Mittelständlers Prozesse vereinfacht, was die neuen LLM-Funktionen konkret können, und warum die lokale Variante mit Ollama beim Datenschutz den Unterschied macht. Die konkrete technische Einrichtung (Docker-Compose, Modellwahl, Konfiguration im Detail) zeigen wir in der Zukunft in einem eigenen, tiefer gehenden Beitrag.
Das eigentliche Problem: Der File-Share ist keine Digitalisierung
Ein Ordner voller PDFs ist streng genommen nichts anderes als ein digitaler Aktenschrank. Die Struktur, die vorher in Leitz-Ordnern und Beschriftungen steckte, wandert eins zu eins in Ordnernamen und Dateibenennungen, mitsamt ihren Schwächen. Ein Dokument gehört oft in mehrere Kategorien gleichzeitig, etwa zu einer Rechnung, einem bestimmten Lieferanten und einem Projekt, aber eine Datei kann nur an einem Ort liegen. Wer sich nicht an die Namenskonvention hält, macht die Suche für alle anderen schwerer, und in der Praxis hält sich irgendwann niemand mehr konsequent daran. Und eine Volltextsuche über den Inhalt der PDFs bieten die wenigsten File-Shares von Haus aus an.
Gerade in kleinen Unternehmen mit ein bis fünf Mitarbeitenden ist das kein Nischenproblem. Dort gibt es selten eine eigene IT-Abteilung, die eine komplexe Dokumentenmanagement-Lösung einführt und pflegt, und genauso selten die Zeit, Ordnerstrukturen laufend zu pflegen. Im Mittelstand kommt eine zweite Dimension dazu: mehrere Abteilungen, mehrere Berechtigungsstufen und der Wunsch, dass eine eingehende Rechnung nicht erst manuell an die Buchhaltung weitergeleitet werden muss, sondern automatisch dort ankommt, wo sie gebraucht wird.
Ein zweiter oft unterschätzter Reibungspunkt liegt vor dem File-Share: Ein großer Teil der Eingangsrechnungen kommt heute per E-Mail an, als Anhang in irgendeinem Postfach. Bevor daraus überhaupt eine Datei im File-Share wird, muss jemand die Mail öffnen, den Anhang speichern, passend benennen und an der richtigen Stelle ablegen, ein manueller Schritt, der bei Krankheit, Urlaub oder schlicht Zeitdruck gerne mal ein paar Tage liegen bleibt. Für Rechnungen kann das ernst werden. Nach § 147 AO müssen Rechnungen und andere steuerrelevante Unterlagen über Jahre hinweg auffindbar und unverändert aufbewahrt werden. Eine Rechnung, die in einem persönlichen Postfach statt im gemeinsamen Archiv liegt, erfüllt das im Zweifel nicht, ganz abgesehen davon, dass sie beim Ausscheiden dieser Person schlicht verschwinden kann.
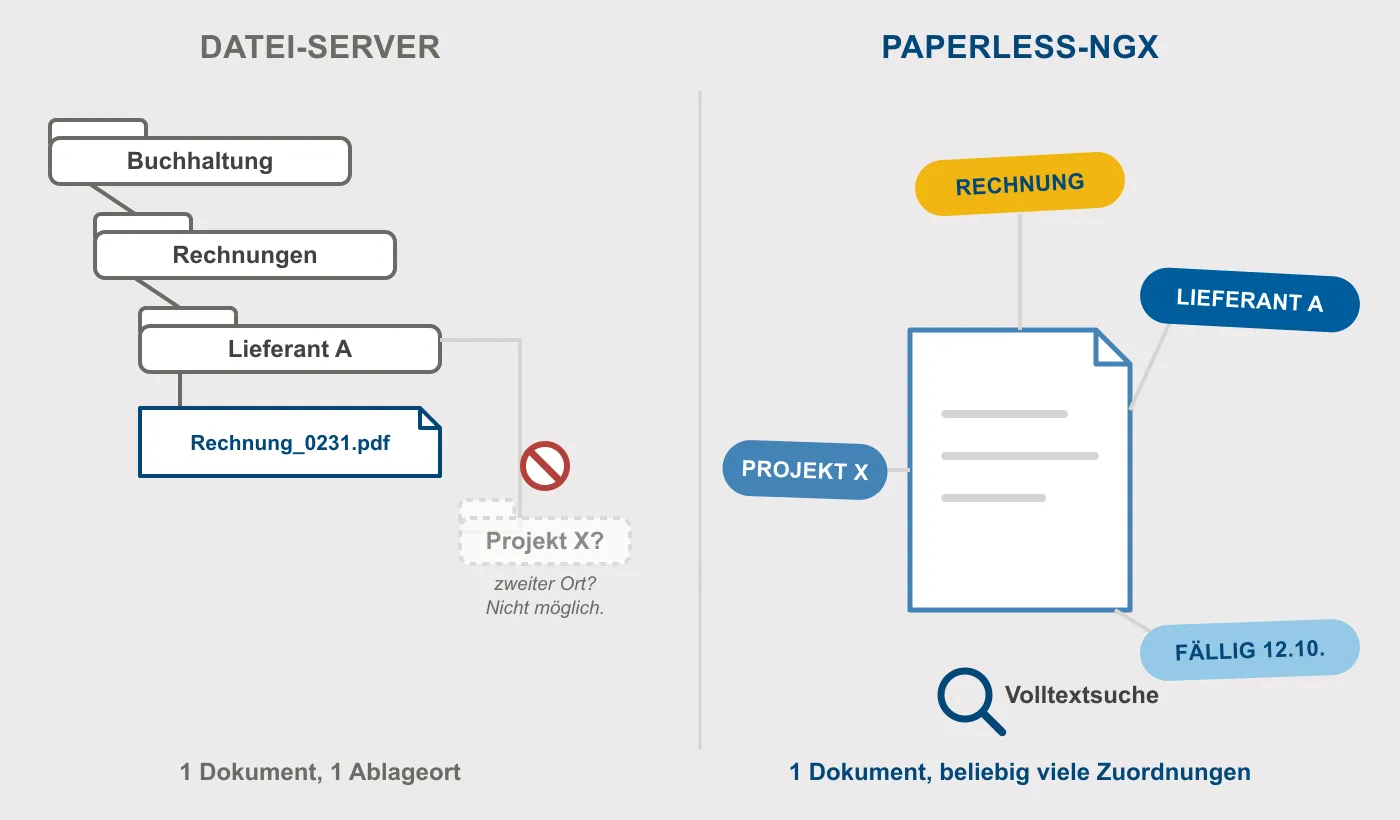
Ein Dateiserver erlaubt nur einen Ablageort pro Dokument. paperless‑ngx verknüpft dasselbe Dokument gleichzeitig mit Dokumenttyp, Korrespondent, Tag und einem Custom Field.
Was paperless‑ngx grundsätzlich löst
paperless‑ngx ist eine quelloffene, selbst gehostete Dokumentenverwaltung. Im Grundprinzip werden die Dokumente über einen Scanner, einen Import-Ordner, eine mobile Scan-App oder ein angebundenes E-Mail-Postfach erfasst, per OCR durchsuchbar gemacht und landen anschließend in einer Datenbank statt in einem Dateibaum. Für den Papierstapel auf dem Schreibtisch reicht damit ein Foto mit dem Smartphone. Der Rest (Texterkennung, Zuordnung, Ablage) läuft automatisch im Hintergrund, ohne dass jemand am Abend noch am Multifunktionsdrucker steht. Statt eines einzelnen Ablageorts bekommt jedes Dokument:
- Tags: beliebig viele Schlagwörter, genau daran scheitert eine Ordnerstruktur mit ihrem „nur ein Ort“-Problem.
- Einen Korrespondenten: wer das Dokument geschickt hat oder wer es bekommt, etwa ein bestimmter Lieferant oder ein Kunde.
- Einen Dokumenttyp: Rechnung, Vertrag, Lohnabrechnung, Angebot und so weiter.
- Einen optionalen Ablagepfad: für alle, die trotzdem eine Ordnerstruktur im Hintergrund brauchen, etwa für Backups oder externe Zugriffe.
Die Volltextsuche durchsucht dabei nicht nur diese Metadaten, sondern den tatsächlichen Text im Dokument. Eine Rechnungsnummer oder ein Name im Fließtext eines gescannten Briefs wird genauso gefunden wie ein Tag.
Für Fälle, in denen Tags und Dokumenttyp nicht reichen, gibt es zusätzlich frei definierbare, typisierte Zusatzfelder (Custom Fields), etwa einen Rechnungsbetrag als Zahl, ein Fälligkeitsdatum oder eine Vertragslaufzeit. Damit lässt sich ein Dokumentenarchiv gezielt um genau die strukturierten Angaben erweitern, die für den eigenen Prozess wichtig sind, ohne gleich eine komplette Datenbank nebenher pflegen zu müssen. Wer irrtümlich zwei Scans desselben Dokuments in unterschiedlicher Qualität hochlädt, muss sie außerdem nicht als zwei getrennte Dokumente stehen lassen. Über die Dokumentversionierung lassen sich mehrere Dateien zu einem Dokument zusammenführen, bei dem eine Version als aktuell gilt. Tags, Korrespondent und Custom Fields bleiben dabei erhalten.
Und weil ein Dokumentenarchiv im Mittelstand selten allen Mitarbeitenden gleichermaßen offenstehen soll, bringt paperless‑ngx ein feingranulares Rechtesystem mit: Sichtbarkeit und Bearbeitungsrechte lassen sich pro Dokument, pro Nutzer oder pro Gruppe vergeben. Die Buchhaltung sieht die Rechnungsablage, die Personalabteilung ihre eigenen Unterlagen, und beide Bereiche kommen sich dabei nicht in die Quere. Genau die Abbildung von Abteilungsgrenzen, die ein einzelner File-Share mit seinem einfachen Ordner-Berechtigungsmodell nur mit wachsendem Aufwand nachbilden kann.
Der eigentliche Hebel für Unternehmensprozesse sind aber die Workflows. Sie bestehen aus Regeln, die bei bestimmten Ereignissen (ein neues Dokument kommt an, ein Dokument wird geändert, ein Zeitplan greift) automatisch Aktionen auslösen. Eine Aktion kann Tags, Korrespondent oder Dokumenttyp setzen. Sie kann aber auch eine E-Mail mit dem Dokument im Anhang verschicken oder einen Webhook auslösen, der ein anderes System anstößt, etwa eine Buchhaltungssoftware. Damit wird aus dem Ablegen von Dokumenten das Automatisieren von Prozessen. Eine Eingangsrechnung, die per E-Mail hereinkommt, wird automatisch als Rechnung erkannt, bekommt Tag und Korrespondent zugewiesen und landet ohne manuellen Zwischenschritt direkt im Postfach der Buchhaltung oder als Beleg im angebundenen Buchhaltungssystem.
paperless‑ngx ist kein GoBD-Archiv im Rechtssinn
Was ist die GoBD? GoBD steht für die „Grundsätze zur ordnungsmäßigen Führung und Aufbewahrung von Büchern, Aufzeichnungen und Unterlagen in elektronischer Form sowie zum Datenzugriff“. Es handelt sich um eine Verwaltungsanweisung des Bundesfinanzministeriums, die festlegt, wie Unternehmen ihre steuerrelevanten Unterlagen elektronisch führen und aufbewahren müssen, unter anderem unveränderbar, vollständig und nachvollziehbar. Sie gilt für praktisch jedes Unternehmen mit eigener Buchführung, unabhängig von Größe oder Branche. Bei einer Betriebsprüfung ist die GoBD-Konformität der elektronischen Ablage ein regelmäßiger Prüfpunkt. Den aktuellen Stand veröffentlicht das Bundesfinanzministerium .
Bei Rechnungen und anderen steuerrelevanten Belegen stößt man allerdings an eine Grenze: paperless‑ngx organisiert und archiviert hervorragend, ist aber von Haus aus kein revisionssicheres Archiv im Sinne der GoBD. Dokumente lassen sich in der Oberfläche bewusst endgültig löschen und, je nach Rechtevergabe, auch nachträglich verändern, genau das, was die GoBD für steuerrelevante Unterlagen ausschließt („unveränderbar und nicht mehr löschbar“). Revisionssicherheit entsteht durch das Zusammenspiel aus Software, Speicherarchitektur, sauber vergebenen Rechten und dokumentierten Abläufen.
In der Praxis heißt das für die meisten kleinen und mittelständischen Unternehmen, dass paperless‑ngx ein ausgezeichnetes Werkzeug ist, um Dokumente überhaupt erst geordnet, durchsuchbar und mit automatisierten Prozessen zu verwalten. Die Aufbewahrungsfunktion einer Finanzbuchhaltungssoftware ersetzt es für die steuerrelevanten Belege aber nicht zwangsläufig. Viele Betriebe fahren deshalb zweigleisig: paperless‑ngx als tägliches Arbeitswerkzeug für Ablage, Suche und Weiterleitung und ein nachgelagertes System (etwa die eigene Buchhaltungssoftware oder ein dediziertes Archiv) für die gesetzlich vorgeschriebene, unveränderliche Langzeitaufbewahrung. Diese Grenze sollte man kennen, bevor man sich allein auf paperless‑ngx als Rechnungsarchiv verlässt.
Neu und ab sofort nativ: KI-Funktionen in paperless‑ngx 3.0/3.1
Bis vor Kurzem gab es KI-gestützte Vorschläge nur über externe Community-Projekte wie paperless-ai , die als separate Container neben paperless‑ngx liefen und über dessen API auf die Dokumente zugriffen. Mit Version 3.0 ist dieser Funktionsumfang in paperless‑ngx selbst eingezogen, als eigenständiges Feature, das standardmäßig deaktiviert ist und sich bei Bedarf gezielt einschalten lässt. Ein Container weniger bedeutet eine Angriffsfläche und eine Wartungsstelle weniger, und die KI-Funktionen greifen direkt auf dieselben Tags, Korrespondenten und Dokumenttypen zu wie der Rest der Anwendung, statt über eine eigene, separat gepflegte API-Anbindung.
Konkret bringt die native Integration in 3.0 drei Dinge:
- Vorschläge auf Knopfdruck. Ein „Suggest“-Button schlägt für ein Dokument Tags, Dokumenttyp, Korrespondent und Titel vor, auf Basis dessen, was das Sprachmodell im Dokumenttext erkennt, abgeglichen mit den bereits vorhandenen Tags und Korrespondenten.
- Chat mit einem einzelnen Dokument. Statt ein langes PDF zu überfliegen, lässt sich eine konkrete Frage dazu stellen; die Antwort wird live im Browser mitgeschrieben. Bei einem mehrseitigen Mietvertrag genügt etwa die Frage „Wie lang ist die Kündigungsfrist?“: Das Sprachmodell liest den erkannten Text und antwortet mit der passenden Stelle, inklusive der Klausel, aus der die Antwort stammt.
- Kontext über mehrere Dokumente hinweg (RAG). Über eine im Hintergrund aufgebaute Ähnlichkeitssuche, technisch einen Vektorindex, zieht paperless‑ngx bei Bedarf passenden Kontext aus anderen Dokumenten heran, bevor das Sprachmodell antwortet. So lassen sich auch Fragen beantworten, die sich nicht auf ein einzelnes Dokument beschränken.
Das kurz darauf erschienene 3.1 hat an genau der Stelle nachgeschärft, die für den Unternehmenseinsatz am meisten zählt. Die Vorschläge bevorzugen jetzt konsequenter bereits vorhandene Tags, Dokumenttypen, Korrespondenten und Ablagepfade, statt bei jedem Dokument neue, leicht unterschiedlich benannte Varianten zu erfinden. Mit kleineren, lokalen Modellen lief man vorher leicht in dieses Problem. Ein bereits angelegtes Tag „Rechnung“ tauchte beim nächsten Dokument plötzlich als „Invoice“ oder „rechnung_2026“ auf, inhaltlich richtig erkannt, aber technisch ein neuer, eigenständiger Tag, der die Tag-Liste über die Zeit aufbläht, statt sie konsistent zu halten. Vor allem aber gibt es seit 3.1 die Workflow-Aktion „AI-Vorschläge anwenden“. Vorschläge müssen damit nicht mehr manuell per Klick bestätigt werden, sondern lassen sich als fester Schritt in einen automatischen Workflow einbauen. Aus dem Beispiel von oben wird damit ein durchgehender Prozess ganz ohne manuellen Zwischenschritt: Eine Rechnung kommt per E-Mail herein, das Sprachmodell erkennt Dokumenttyp und Korrespondent, der Workflow übernimmt den Vorschlag und leitet das fertig getaggte Dokument im selben Zug an die Buchhaltung weiter.
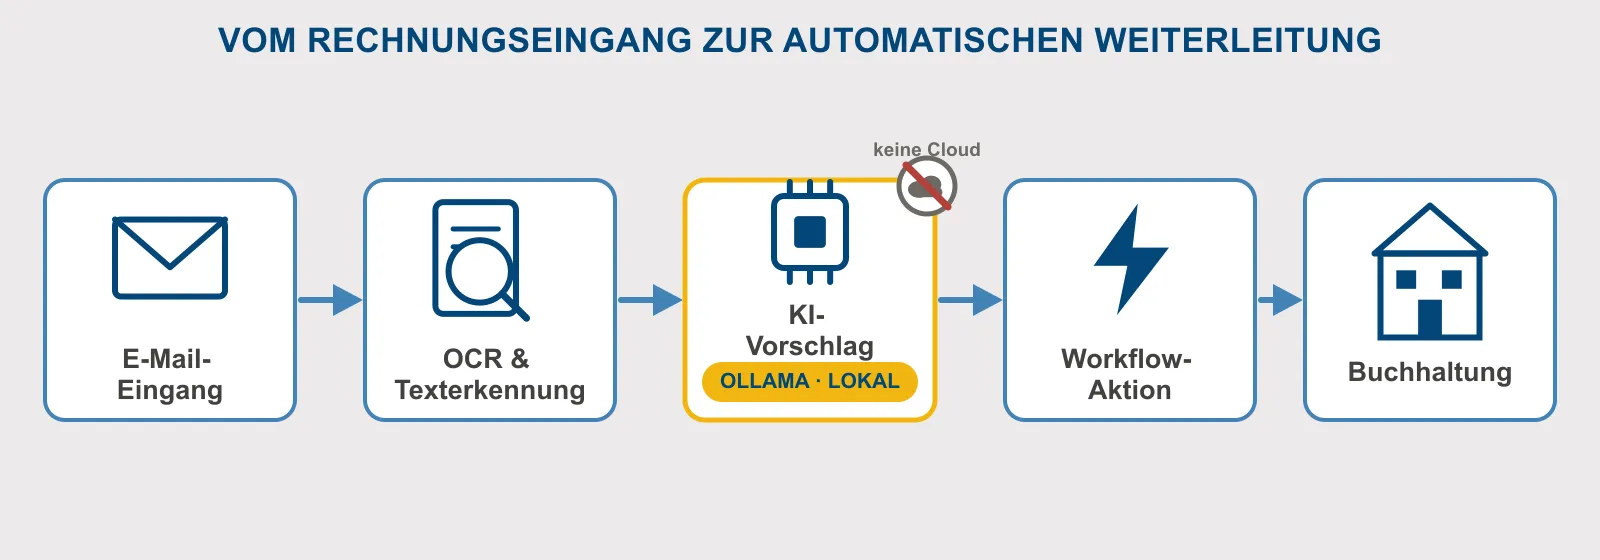
Vom Rechnungseingang per E-Mail bis zur automatischen Weiterleitung an die Buchhaltung. Die KI-Vorschläge laufen dabei komplett lokal über Ollama, ohne Cloud-Anbindung.
Für die eigentliche Sprachmodell-Anfrage unterstützt paperless‑ngx wahlweise die OpenAI-API oder eine lokale Ollama -Instanz als Backend, konfiguriert über wenige Umgebungsvariablen, ganz ohne zusätzlichen Container-Wildwuchs. Auch die Embeddings (die Vektoren hinter der Ähnlichkeitssuche) lassen sich wahlweise lokal oder über einen externen Anbieter berechnen.
Mit Ollama bleiben die Daten im eigenen Netz
Genau an dieser Backend-Wahl hängt die Datenschutzfrage. Ein Dokumentenarchiv enthält fast zwangsläufig personenbezogene und geschäftskritische Daten: Rechnungsadressen, Kontoverbindungen, Gehaltsdaten, Vertragsinhalte. Läuft das Sprachmodell über eine Cloud-API, verlässt bei jeder Vorschlags- oder Chat-Anfrage zumindest der Dokumenttext das eigene Netzwerk und landet bei einem externen Anbieter, und mit ihm potenziell all diese Daten. Rechtlich muss man das im Blick behalten. Sobald personenbezogene Daten von einem externen Dienstleister verarbeitet werden, braucht es nach Art. 28 DSGVO in aller Regel einen Auftragsverarbeitungsvertrag mit genau diesem Anbieter. Dazu kommt die Frage, in welchem Land dessen Server stehen und ob von dort aus weitere Unterauftragsverarbeiter im Spiel sind. Das ist für ein einzelnes KI-Feature in einer Dokumentenverwaltung schnell mehr Verwaltungsaufwand, als das Feature an Zeit einspart, gerade wenn ohnehin schon mehrere andere Cloud-Dienste denselben Prüfaufwand verursachen.
Mit Ollama als Backend läuft dasselbe Sprachmodell stattdessen auf eigener Hardware im lokalen Netz. Die Anfrage an das Modell verlässt den Server nicht, auf dem paperless‑ngx läuft. Es gibt schlicht keine externe Schnittstelle, über die Dokumentinhalte abfließen könnten, und damit auch keinen zusätzlichen Auftragsverarbeiter, den man vertraglich und organisatorisch absichern müsste. Vorschläge, Chat und Ähnlichkeitssuche funktionieren genauso, nur eben vollständig unter eigener Kontrolle.
Dafür braucht man mehr Rechenleistung als für einen einfachen Dokumentenserver. Für kurze Vorschläge und Fragen zu einzelnen Dokumenten reichen inzwischen aber kompakte, frei verfügbare Modelle. Sie liefern schon auf einer einzelnen Grafikkarte, die keine High-End-Karte sein muss, Antworten im Sekundenbereich, ohne dass ein eigener Serverraum dafür nötig ist. Wie schnell das im eigenen Dokumentenbestand tatsächlich läuft, welches Modell sich für welchen Anwendungsfall eignet und wie die Einrichtung von Ollama neben paperless‑ngx konkret aussieht, zeigen wir in der Zukunft in einem technisch tiefer gehenden Beitrag.
Für wen sich der Umstieg lohnt
Für ein Ein-Personen-Unternehmen mit einer Handvoll Rechnungen im Monat ist der Umstieg auf ein vollwertiges Dokumentenmanagement wahrscheinlich mehr Aufwand, als er an Zeit spart. Ein sauber gepflegter Ordner tut es dort noch. Sobald aber mehrere Personen auf denselben Dokumentenbestand zugreifen, zahlen sich Volltextsuche und konsistentes Tagging spürbar aus: Man muss nur noch wissen, wonach man sucht. Und das trifft schon auf viele Betriebe mit ein bis fünf Mitarbeitenden zu. Ein Handwerksbetrieb in genau dieser Größenordnung, bei dem bislang eine Person nebenbei alle Eingangsrechnungen sichtet und per Hand an die externe Steuerkanzlei weiterleitet, gewinnt allein durch die automatische Rechnungserkennung und -weiterleitung deutlich Zeit zurück. Eine eigene IT-Stelle ist dafür nicht nötig, weil sich paperless‑ngx mit überschaubarem Aufwand selbst betreiben oder als gehostete Lösung beziehen lässt.
Im Mittelstand, mit mehreren Abteilungen und wiederkehrenden Abläufen wie der Rechnungsprüfung, kommen die Workflows und das Rechtesystem dazu. Prozesse, die bisher an einer Person oder einer manuellen Weiterleitung hingen, laufen dann automatisch und nachvollziehbar im Hintergrund, während jede Abteilung nur die Dokumente sieht, für die sie tatsächlich zuständig ist. Auch Abläufe, die an Fristen gebunden sind, etwa eine Kündigungsfrist im Vertrag oder ein Ablaufdatum in einer Versicherungspolice, lassen sich über Custom Fields und darauf aufsetzende, zeitgesteuerte Workflows abbilden. Die separate Excel-Liste zur Wiedervorlage, die erfahrungsgemäß irgendwann nicht mehr gepflegt wird, entfällt damit.
Die KI-Funktionen beschleunigen diese Grundlage, ersetzen sie aber nicht. Wer Tags und Dokumenttypen noch nicht konsequent vergibt, profitiert von genau dieser Struktur. Die automatischen Vorschläge machen es leichter, sie aufzubauen, weil ein Großteil der Zuordnung nicht mehr von Hand erledigt werden muss. Gerade wenn ein über Jahre gewachsener Aktenberg nachträglich eingepflegt wird, macht das den Unterschied zwischen einer Digitalisierung, die Monate an manueller Sortierarbeit kostet, und einer, die überwiegend im Hintergrund mitläuft.
Ausblick
In der Zukunft zeigen wir die praktische Umsetzung: ein lauffähiges Docker-Compose-Setup aus paperless‑ngx und Ollama, ein Vergleich, welche frei verfügbaren Modelle sich für Tagging-Vorschläge und Dokument-Chat eignen und welche eher nicht, sowie die relevanten Umgebungsvariablen im Detail.
Wenn Sie überlegen, paperless‑ngx samt lokaler KI in Ihrem Unternehmen einzuführen, unterstützen wir Sie dabei gerne, von der ersten Einrichtung bis zur Anbindung an bestehende Abläufe wie die Buchhaltung. Sprechen Sie uns einfach an.
Wichtige Themen und Links
- paperless‑ngx : quelloffene, selbst gehostete Dokumentenverwaltung mit OCR, Tags, Korrespondenten und Workflows.
- paperless‑ngx: Workflows : Automatisierung über Trigger (neues Dokument, Änderung, Zeitplan) und Aktionen (Metadaten setzen, E-Mail, Webhook).
- paperless‑ngx: Custom Fields : frei definierbare, typisierte Zusatzfelder für strukturierte Angaben wie Rechnungsbetrag oder Fälligkeitsdatum.
- Ollama : Werkzeug zum lokalen Betrieb von Sprachmodellen, ohne Cloud-Anbindung.
- paperless‑ngx Pull Request #10319 : die native KI-Integration (Vorschläge, Dokument-Chat, RAG), erstmals in Version 3.0 enthalten.
- Release-Notes paperless‑ngx 3.1.0 : unter anderem die neue Workflow-Aktion „AI-Vorschläge anwenden“.
- paperless-ai : älteres, eigenständiges Community-Projekt für KI-gestütztes Tagging, ebenfalls mit Ollama-Unterstützung.